ChatGPT bekommt in der EU unsichtbare Text-Wasserzeichen – OpenAI startet mit textGrain
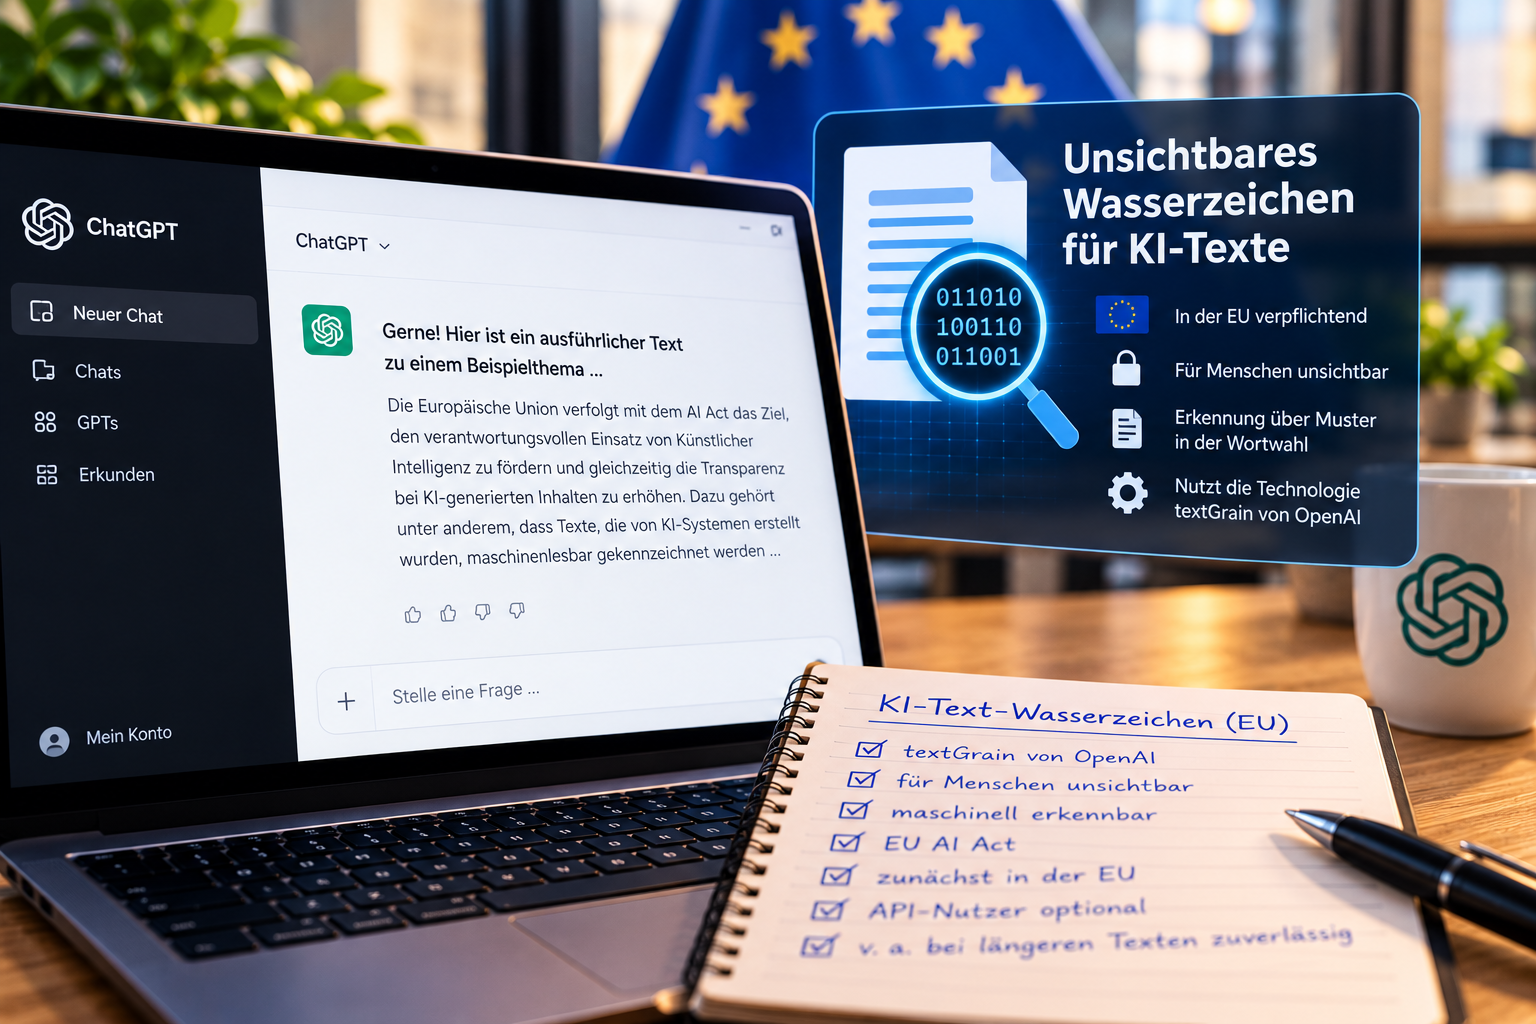
OpenAI führt für von ChatGPT erzeugte Texte in der Europäischen Union ein unsichtbares, maschinenlesbares Wasserzeichen ein. Hintergrund sind die Transparenzanforderungen des EU AI Act.
Dabei handelt es sich allerdings nicht um irgendein verstecktes Zeichen, das beim Kopieren plötzlich irgendwo im Text auftaucht. OpenAI nutzt dafür eine eigene Technologie namens textGrain, die wesentlich subtiler arbeitet.
Was genau wird dabei in den Text eingebaut?
Eigentlich wird gar nichts im klassischen Sinne „eingebaut“.
textGrain verändert leicht die statistische Auswahl der Wörter beziehungsweise Tokens, die das Modell während der Texterzeugung auswählt.
Dadurch entsteht über einen längeren Text hinweg ein bestimmtes Muster, das ein entsprechender Detektor erkennen kann.
Wichtig dabei:
Es werden keine versteckten Zeichen, unsichtbaren Leerzeichen oder besonderen Satzzeichen eingefügt.
Wenn ihr einen ChatGPT-Text kopiert und beispielsweise in Word oder auf eine Webseite einfügt, schleppt ihr also nicht plötzlich geheime Zeichen mit euch herum. Das Signal steckt in der Formulierung selbst.
In der EU wird das Wasserzeichen automatisch kommen
OpenAI hat angekündigt, die Funktion in den kommenden Wochen für geeignete Textausgaben von ChatGPT und Codex in der Europäischen Union einzuführen.
Das betrifft Nutzer über alle ChatGPT-Pläne hinweg.
Außerhalb der EU soll die Textmarkierung zunächst nicht automatisch zum Standard werden.
API-Nutzer können textGrain bereits aktivieren
Für Entwickler sieht es etwas anders aus.
API-Kunden weltweit können das Text-Wasserzeichen bereits optional für unterstützte Modelle aktivieren.
Standardmäßig bleibt es bei der API allerdings ausgeschaltet.
Damit können Unternehmen selbst entscheiden, ob sie ihre über die OpenAI-API erzeugten Texte entsprechend kennzeichnen möchten.
Das Wasserzeichen ist nicht unzerstörbar
Das ist wahrscheinlich der wichtigste Punkt.
Ein Text-Wasserzeichen funktioniert nicht wie ein digitales Siegel, das sich niemals entfernen lässt.
OpenAI weist selbst darauf hin, dass die Erkennung schwieriger wird, wenn ein Text:
- sehr kurz ist
- stark umgeschrieben wird
- paraphrasiert wird
- übersetzt wird
- wenig sprachlichen Spielraum bietet
Je stärker ein Text verändert wird, desto schwieriger kann es werden, das ursprüngliche Muster zuverlässig nachzuweisen.
Kurze Texte sind besonders schwierig
Bei längeren Texten hat ein statistisches Verfahren natürlich wesentlich mehr Material, das ausgewertet werden kann.
Bei zwei oder drei Sätzen sieht das anders aus.
OpenAI macht deshalb ausdrücklich deutlich, dass ein nicht erkanntes Wasserzeichen kein Beweis dafür ist, dass ein Text von einem Menschen geschrieben wurde.
Das halte ich für einen wichtigen Unterschied zu den vielen angeblichen „KI-Detektoren“, die heute teilweise mit ziemlich selbstbewussten Prozentwerten daherkommen.
Auch ein Treffer beweist nicht alles
Umgekehrt bedeutet ein erkanntes OpenAI-Wasserzeichen lediglich, dass ein OpenAI-System den Text wahrscheinlich erzeugt oder bearbeitet hat.
Es sagt beispielsweise nicht:
- wer den Text erstellt hat
- wem der Text gehört
- wie stark ein Mensch ihn anschließend verändert hat
- wie groß der KI-Anteil war
- ob der Inhalt sachlich korrekt ist
Das Wasserzeichen ist also ein Herkunftssignal, kein Beweis über Autorenschaft oder Wahrheit.
Der Detektor wird vorerst nicht für jeden verfügbar sein
Interessant ist auch, dass OpenAI den dazugehörigen Text-Detektor zunächst nicht öffentlich freigibt.
Zugang sollen anfangs ausgewählte Forscher und Fachorganisationen erhalten.
OpenAI begründet das unter anderem damit, dass solche Systeme weiterhin falsch-positive und falsch-negative Ergebnisse liefern können und die Technologie noch verbessert werden muss.
Das bedeutet also nicht, dass demnächst jeder einen Text auf eine OpenAI-Webseite werfen und mit absoluter Sicherheit feststellen kann:
„Dieser Text stammt von ChatGPT.“
So einfach wird es weiterhin nicht sein.
Hat das Auswirkungen auf die Qualität der Antworten?
Laut OpenAI sollen die Auswirkungen auf die Modellqualität praktisch nicht messbar sein.
In internen Tests lagen Unterschiede zwischen Ausgaben mit und ohne Wasserzeichen innerhalb der normalen Schwankungen der Evaluationen.
Auch die Geschwindigkeit soll dadurch nur vernachlässigbar beeinflusst werden.
Für Nutzer sollte sich beim normalen Schreiben mit ChatGPT also im Idealfall überhaupt nichts bemerkbar machen.
Warum macht OpenAI das?
Der wesentliche Auslöser ist der EU AI Act.
Dessen Transparenzregeln verlangen von Anbietern generativer KI, entsprechende Inhalte in maschinenlesbarer Form identifizierbar zu machen.
OpenAI unterstützt außerdem den europäischen Code of Practice zur Transparenz KI-generierter Inhalte.
OpenAI arbeitet daneben schon länger an Herkunftssignalen für andere Medien.
Bei Bildern kommen beispielsweise Content Credentials und SynthID zum Einsatz, bei unterstützten Audioinhalten ebenfalls unsichtbare Wasserzeichen. Text ist aufgrund seiner einfachen Veränderbarkeit allerdings deutlich schwieriger zuverlässig zu markieren.
Mein Eindruck
Ich finde die technische Umsetzung interessanter als die eigentliche Pflicht dahinter.
Viele dürften bei „unsichtbarem Wasserzeichen“ zunächst an irgendwelche versteckten Unicode-Zeichen oder Metadaten denken.
Genau das ist hier aber nicht der Fall.
Das Signal entsteht durch die Wortwahl des Modells selbst.
Gleichzeitig sollte man die Möglichkeiten nicht überschätzen. Ein stark überarbeiteter Text wird schwieriger zu erkennen sein, und ein fehlender Treffer beweist nicht, dass keine KI beteiligt war.
Das Wasserzeichen kann also zusätzliche Transparenz schaffen – ein perfekter KI-Detektor wird daraus aber nicht.
Fazit
OpenAI führt mit textGrain künftig unsichtbare Wasserzeichen für geeignete ChatGPT- und Codex-Texte innerhalb der EU ein.
API-Nutzer können die Funktion weltweit bereits freiwillig aktivieren.
Für Leser bleibt das Wasserzeichen unsichtbar, da keine geheimen Zeichen oder zusätzlichen Daten in den Text eingefügt werden. Stattdessen erzeugt das Modell durch seine Wortwahl ein statistisches Muster.
Technisch ist das durchaus spannend.
Aber genauso wichtig ist die Einschränkung:
Ein erkanntes Wasserzeichen ist ein Hinweis auf OpenAI-Ursprung – und ein nicht erkanntes Wasserzeichen ist kein Beweis für menschliche Autorenschaft.
Genau diese Grenze sollte man im Hinterkopf behalten, wenn solche Systeme künftig häufiger zur Einordnung von KI-generierten Inhalten eingesetzt werden.